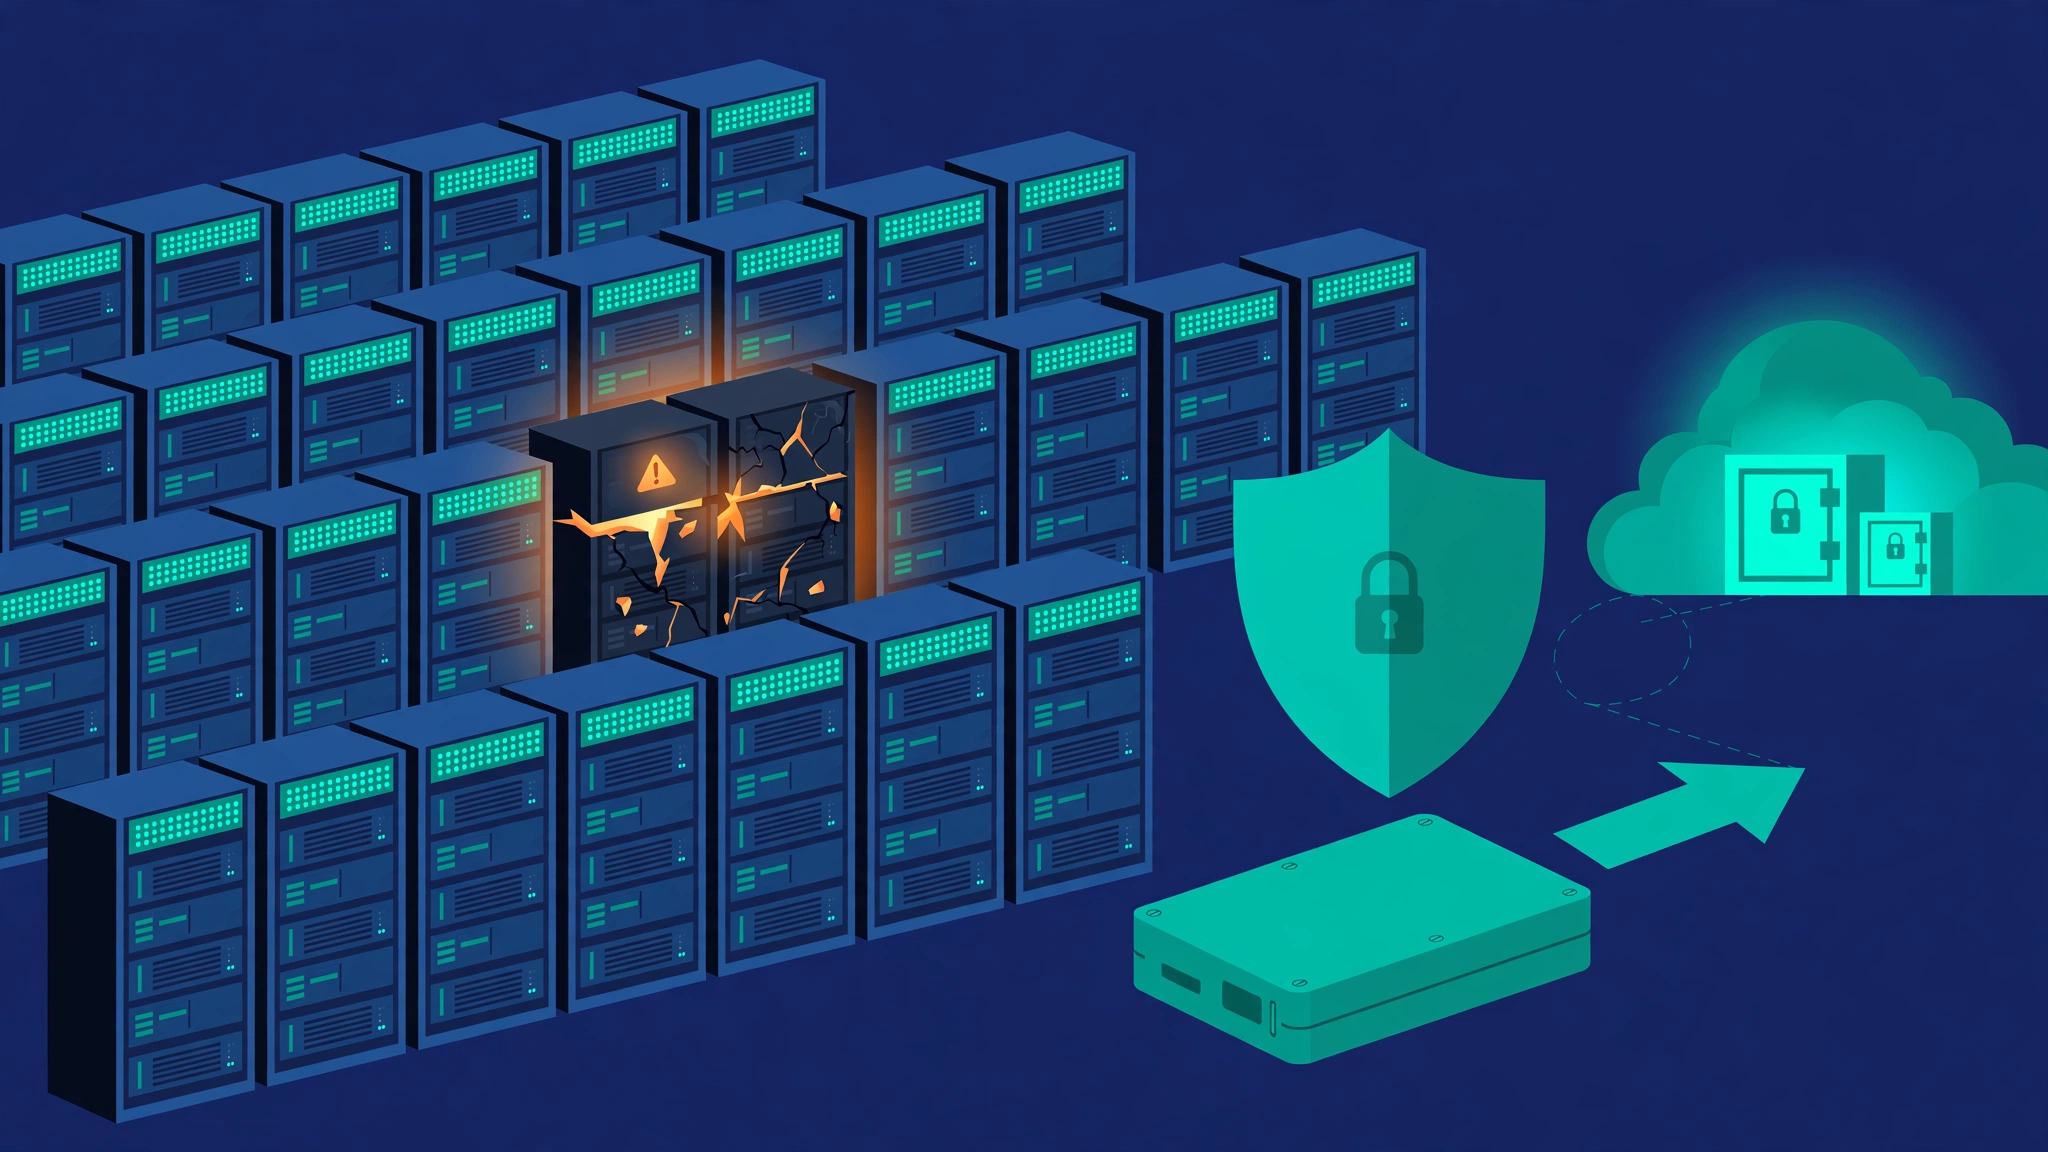
2026 年 11 月 2 日凌晨,俄罗斯最大的主机服务商之一 Beget 遭到大规模网络攻击。随后几天确认的消息让人倒吸凉气:云基础设施里 VPS、对象存储(S3)和 Kubernetes 的数据丢失,CDN 配置和 IP 设置也没了,只有文件级备份得以保留,VPS 的整机镜像备份全部丢失。公司宣布进入不可抗力状态,恢复要靠人工逐台检查 1000 多台服务器,至今没有完整恢复的时间表。
Beget 的客户有 20 多万用户、30 多万个网站在上面跑。对我们这些在 VPS 上跑博客、跑代理、跑面板的人来说,这件事真正值得问的只有一个:如果明天轮到我的服务商,我的数据还在吗?
事件经过:丢了什么,保住了什么
- 11 月 2 日凌晨 3 点前后,攻击发生,面板、用户中心、网站陆续无法访问,大量用户报 502 错误,邮件和 DNS 也受波及。
- 数据损失:VPS、S3、Kubernetes 的数据丢失,CDN 设置和 IP 配置丢失。保住的是文件级备份,但 VPS 的二进制备份(可直接恢复整台机器的镜像)已经没了。
- 恢复方式:人工逐台检查 1000 多台服务器,DNS 预计需要约 14 天。公司宣布此次事件属于不可抗力,全额赔偿的前景很渺茫。
还有一个背景值得注意:2026 年 10 月,俄罗斯已有多家主机商报告被入侵,问题出在虚拟化管理面板 VMmanager 6 的漏洞上。这次攻击很可能不是某一家服务商的偶然倒霉,而是针对整个主机行业供应链的一波打击。
教训一:"服务商有备份"不等于你的数据安全
很多人买 VPS 时默认服务商会兜底。Beget 事件戳破了这个假设:
第一,服务商的备份首先保的是它自己,不是你。 它的备份体系服务于自身的灾难恢复:先恢复控制面板、计费、网络这些基础设施,单个客户的数据排在后面。轮到你时,可能已经是几天甚至几周之后。
第二,备份分两种,丢的恰恰是最有用的那种。 文件级备份只能恢复网站文件、数据库导出这类"文件";二进制备份(快照/整机镜像)才能一键恢复整台机器的系统、配置和运行状态。Beget 丢的正是后者——文件还在,重建一台能跑的机器也要从装系统、装服务、改配置从头来过。
第三,备份和数据放在同一个篮子里,等于没有备份。 攻击者能进生产系统,往往也能摸到同一套基础设施里的备份。能救命的备份,一定在攻击者够不着的地方:另一个服务商、另一台机器、甚至你家里的硬盘。
教训二:3-2-1 法则,30 分钟就能落地
备份行业的经典法则是 3-2-1:至少 3 份数据,存放在 2 种不同介质上,其中 1 份在异地。对个人 VPS 用户,可以简化成三步:
1. 每天自动打包关键数据。 先分清什么是"丢了就再也找不回来"的东西:网站文件、数据库、sing-box 配置、面板数据。一条定时任务就够:
# 每天凌晨 3 点打包网站与数据库,保留最近 7 天
0 3 * * * tar -czf /backup/site-$(date +\%F).tar.gz /var/www/你的站点 && mysqldump -u root -p'你的密码' 你的数据库 | gzip > /backup/db-$(date +\%F).sql.gz && find /backup -mtime +7 -delete2. 把备份推到另一家服务商。 用 rclone 把备份目录同步到另一家云厂商的对象存储,或另一台 VPS。关键点是异地、异厂商——同一家服务商的另一个机房不算异地,同一波攻击可能一起端掉。
rclone sync /backup 异地存储:我的备份桶3. 配置也要备份,别只备份数据。 很多人备份了网站文件,却丢了 nginx 配置、sing-box 的 config.json、防火墙规则和定时任务。机器丢了可以重买,配置丢了要凭记忆重写。把 /etc/nginx、/etc/sing-box 和 crontab -l 的输出一起打进备份包,恢复时能省下大半天。
教训三:没演练过的备份,等于没有备份
备份文件躺在对象存储里,不代表你真的能恢复。每季度花 20 分钟做一次"灾难演习":找一台临时机器(甚至本地虚拟机),把最近的备份解压、导入,看网站能不能跑起来。Beget 的客户现在才发现,"文件备份还在"和"网站能恢复"之间隔着漫长的手工重建——你提前演练一次,就能提前发现缺了哪个配置文件。
同时把恢复步骤写成半页纸的清单:新机器装什么系统、装哪些包、从哪下载备份、按什么顺序恢复。真出事的那天,你大概率是半夜被叫醒的,脑子不清醒,有清单和没清单是两回事。
教训四:关键服务别全押在一家
Beget 事件里最惨的不是网站挂了几天,而是 DNS、邮件、VPS、面板全在一家手里,一锅端。个人用户可以做的分离很简单:域名解析用 Cloudflare 这类独立服务商,VPS 挂了域名还能指到备用机器;邮箱别绑在同一台 VPS 上,机器丢了连服务商的通知邮件都收不到;重要服务准备一台最便宜的备用小鸡,平时同步一份配置和数据,主力挂了能先顶上。
今晚就能做的检查清单
- 列出 VPS 上"丢了无法重建"的东西(网站数据、数据库、配置、密钥)。
- 写一条定时任务,每天打包并推送到异地存储。
- 把
/etc下的关键配置和crontab输出加进备份。 - 在本地或另一台机器上试一次恢复,确认备份真的能用。
- 把域名解析和邮箱从 VPS 服务商手里拆出来。
Beget 的恢复还在进行中,1000 多台服务器的人工检查不知道要持续几周。这件事对普通用户的提醒其实很朴素:服务商的规模不是你的安全边界,你自己的备份才是。 备份这件事,永远是"没出事时觉得多余,出事后觉得太晚"——趁现在还没轮到你,把它做了。
参考来源: 事件进展可参考 Habr 的报道、ServerNews 的通报与 Vedomosti 的消息。